Home
» Hoe
»
Een SUSE-server diagnosticeren die vastloopt op het systemd-afsluitscherm.
Een SUSE-server diagnosticeren die vastloopt op het systemd-afsluitscherm.
Als SUSE Linux Enterprise Server vastloopt tijdens het afsluiten met systemd, identificeer dan de eenheid met een actieve stoptaak of controleer de laatste berichten van de vorige opstart en los het probleem met die eenheid of de bijbehorende afhankelijkheid op. Een eenheid is een door systemd beheerde bron, zoals een service of een mount; een stoptaak is een verzoek van systemd om er een af te sluiten. Verlaag niet eerst een globale time-out en forceer het systeem niet uit, omdat een service of bestandssysteem mogelijk nog steeds bestanden sluit of gegevens schrijft.
Deze stappenplan volgt de SLES 15 SP7-documentatie zoals die in oktober 2026 is gecontroleerd. Het exacte stopbeleid is afhankelijk van de service- en opslagleverancier, dus raadpleeg hun richtlijnen voor eventuele unit-specifieke wijzigingen.
1. Observeer de veilige uitschakeling.
Stap 1: Noteer het exacte bericht en wacht op bruikbaar bewijs.
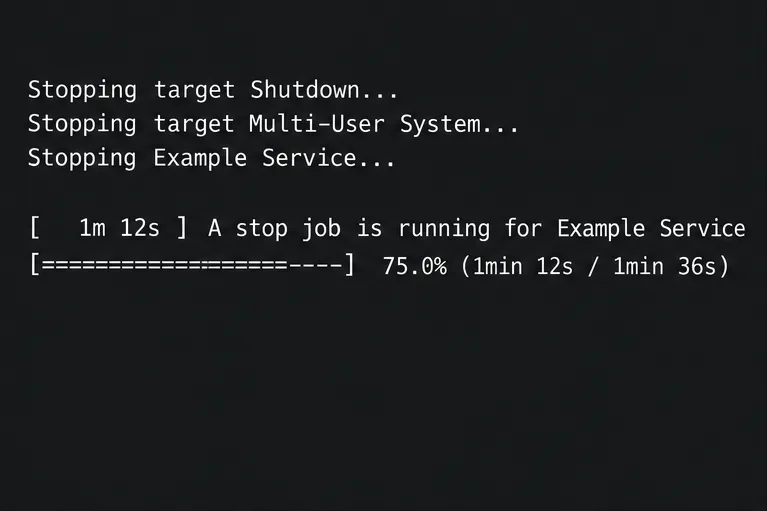
Als de console "Een stoptaak wordt uitgevoerd voor ..." met een aftelling weergeeft, noteer dan de naam van de service of het mountpunt en of de timer verandert. Dit betekent dat systemd wacht op de stopbewerking van die eenheid, niet per se dat het besturingssysteem is vastgelopen; databases en externe opslag hebben mogelijk tijd nodig om correct af te sluiten.
Een voorbeeld van een consolebericht geeft de naam van de eenheid waarop systemd wacht; de weergegeven service en aftelling zijn slechts ter illustratie.
Observeer via een externe of seriële console, of een andere beschikbare terminal. Vermijd reset- of aan/uit-opdrachten terwijl er mogelijk schrijfbewerkingen worden uitgevoerd. Als het systeem niet meer reageert, noteer dan de laatst zichtbare regel en ga verder nadat het systeem is opgestart.
2. Zoek de wachtende eenheid.
Stap 2: Controleer de systemd-taken om te zien of de machine nog steeds opdrachten accepteert.
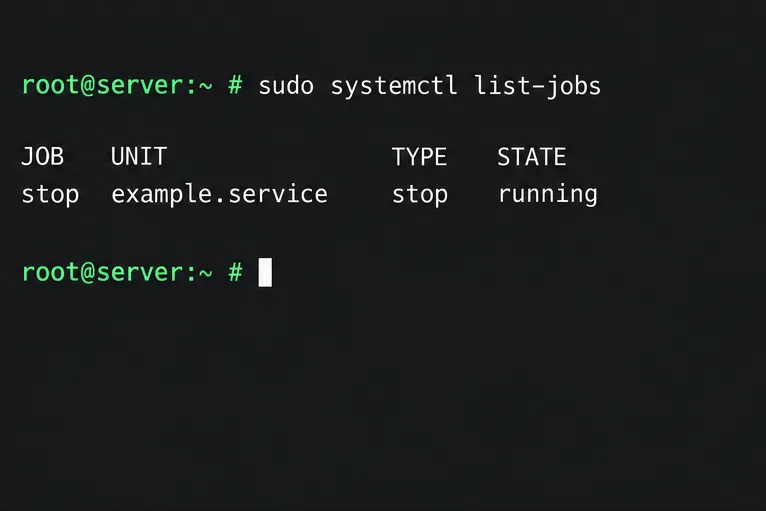
Als SSH of een tweede terminal nog steeds werkt, vraag dan aan systemd welke taken actief zijn of in de wacht staan, en controleer vervolgens de eenheid die op het scherm wordt weergegeven:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service
De takenlijst kan een service identificeren waarvan de stopbewerking nog steeds actief is; de getoonde regel is een voorbeeld.
Vervang dit SERVICEdoor de daadwerkelijke eenheidsnaam. Een actieve stoptaak verkleint de zoekmarge, maar verklaart niet waarom het proces niet is afgesloten. Lees de status en logboeken voordat u de configuratie wijzigt. Als systemd niet meer reageert, annuleer dan niet blindelings taken; controleer het vorige logboek nadat de host weer actief is.
3. Gebruik de vorige opstartprocedure om de oorzaak te achterhalen.
Stap 3: Lees het einde van het logboek van de vorige opstart.
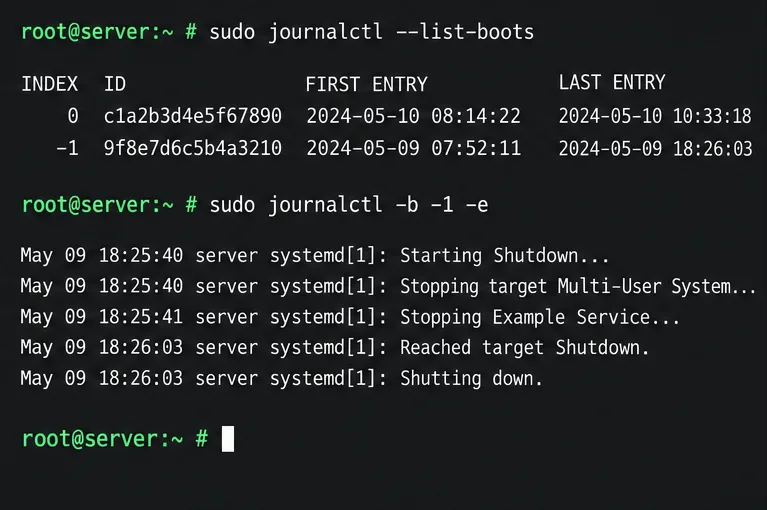
Het logboek is het geïndexeerde logboek van systemd met kernel-, service- en systeemberichten. Na de volgende succesvolle opstart kunt u de geregistreerde opstartpogingen weergeven en het einde van de vorige opstart bekijken:
De -1offset selecteert de voorgaande opstart en -egaat verder naar de meest recente vermeldingen daarvan.
Zoek naar het laatste "Stopping"-bericht, een time-out, herhaalpogingen of een benoemd apparaat of mount. De laatste regel is slechts een aanwijzing: de afsluitvolgorde kan ervoor zorgen dat een andere eenheid erachter blijft wachten. Vergelijk de tijdstempels en nabijgelegen berichten.
Stap 4: Filter de logboeken op de verdachte service.
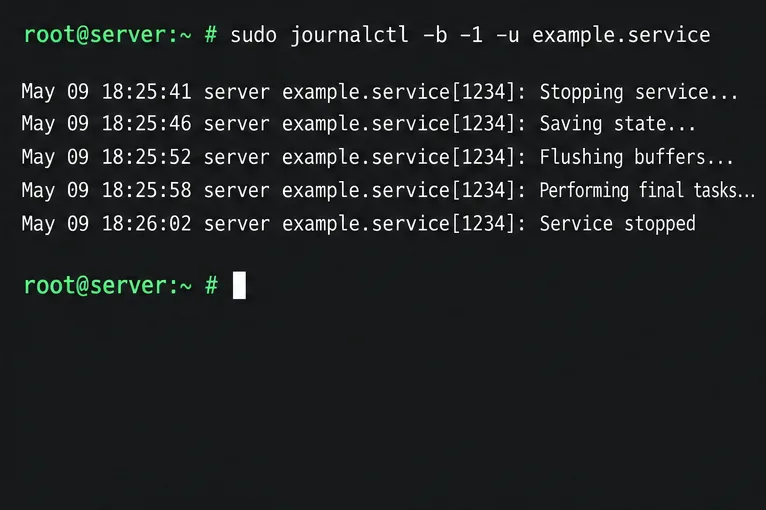
Wanneer het scherm of logboek een service noemt, raadpleeg dan alleen de opstartgegevens van die unit. Controleer ook de geladen configuratie:
Door te filteren op eenheid kan een langzame service-afsluiting worden onderscheiden van ongerelateerde berichten elders in het logboek.
Controleer op een aangepast ExecStopscript, een script dat oneindig lang wacht, een achtergebleven subproces of een toepassingsfout in de afsluithook. Vergelijk voor leveranciersspecifieke producten het pakket en de configuratie met de ondersteunde richtlijnen voordat u wijzigingen aanbrengt.
Stap 5: Controleer de montages en de opslag alleen als daar aanwijzingen voor zijn.
Als het logboek een mount, apparaat of extern bestandssysteem noemt, controleer dan de mounttabel en de overeenkomende vermelding in /etc/fstab:
sudo findmnt --verify --verbose
Gebruik de mount-verificatiefunctie wanneer de logboeken een mount-verbinding betreffen; de weergegeven vermeldingen zijn slechts voorbeelden en moeten worden gecontroleerd aan de hand van de host.
Controleer of een NFS-, CIFS-, iSCSI- of andere externe afhankelijkheid bereikbaar en verwacht is tijdens het afsluiten. Verwijder een verouderde mount-vermelding pas nadat u hebt bevestigd dat deze niet meer wordt gebruikt. Forceer het ontkoppelen van een actief bestandssysteem niet alleen op basis van een trage herstart.
4. Pak de oorzaak aan zonder deze te verbergen.
Stap 6: Herstel de service of pas alleen het gedocumenteerde stopbeleid aan.
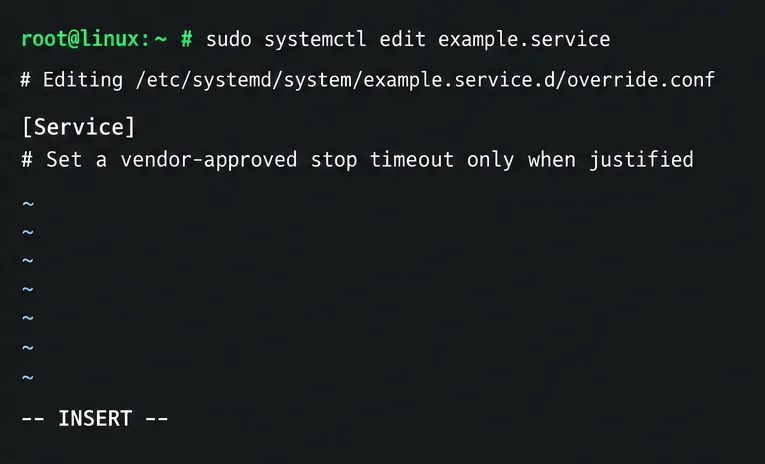
Voor een service die niet afsluit, moet u eerst het afsluitscript, de applicatieconfiguratie of het pakketprobleem oplossen. Een drop-in per eenheid sudo systemctl edit SERVICE.servicewordt opgeslagen /etc/systemd/system/zonder het leveranciersbestand te hoeven bewerken. SUSE-documentatie TimeoutSecvoor het starten of stoppen van services; gebruik een door de leverancier goedgekeurde waarde voor deze workload.
Een unit drop-in kan een gerichte override bevatten; de getoonde opmerking is een richtlijn, geen time-outwaarde.
Na een gedocumenteerde bewerking laadt u de unitdefinities van systemd opnieuw met sudo systemctl daemon-reloaden controleert u het resultaat met sudo systemctl cat SERVICE.service. Een langere time-out kan een legitieme afsluiting voltooien, maar kan ook een mislukte herstart verlengen. Een kortere time-out kan een service beëindigen voordat de status wordt gewist. Wijzig geen globale standaardinstellingen om een defect in één unit te verbergen.
Stap 7: Bewaar de logbestanden voor het volgende incident.
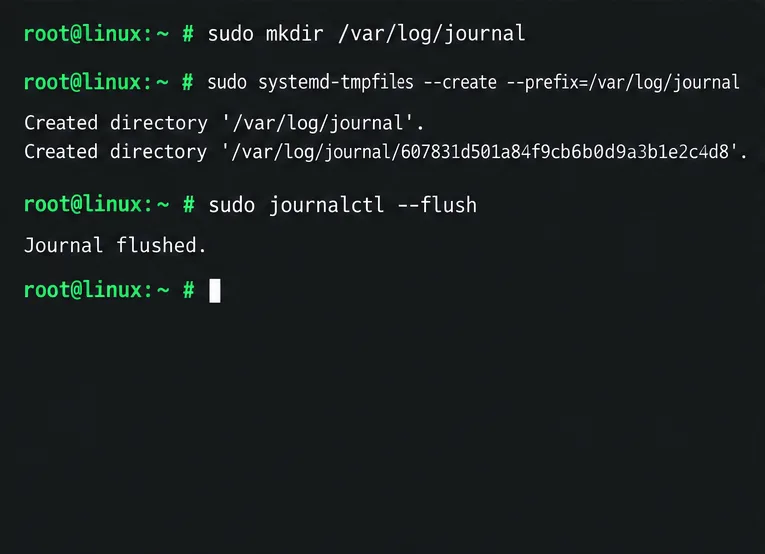
SLES slaat standaard loggegevens op in een /run/log/journal/map die tijdelijk is en die bij het opnieuw opstarten wordt leeggehaald. Als journalctl -b -1er geen eerdere opstartgegevens aanwezig zijn, schakel dan permanente logopslag in voor toekomstige diagnose.
Deze commando's zorgen ervoor dat nieuwe logboekvermeldingen ook na een herstart behouden blijven; ze kunnen echter geen logboeken herstellen die al verloren zijn gegaan van de tijdelijke opslag.
Permanente logbestanden nemen ruimte in beslag onder /var; SUSE merkt op dat het logboek standaard tot 10 procent van dat bestandssysteem kan gebruiken. Controleer de vrije ruimte en de bewaartermijn, vooral op kleine /varvolumes.
5. Controleer de volgende geplande herstart
Stap 8: Controleer of de stop is voltooid en de server weer in bedrijf is.
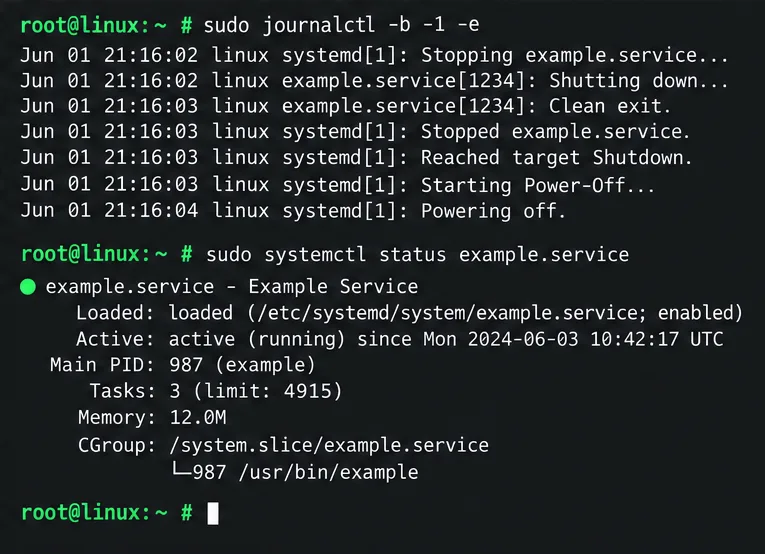
Zodra de vermoedde oorzaak is verholpen, plan dan een gecontroleerde herstart met consoletoegang. Controleer na de herstart de laatste berichten van de vorige opstart en de huidige status van de service.
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service
Controleer na een latere herstart of de vorige afsluiting de laatste berichten heeft bereikt en of de service weer gezond is; dit is een voorbeeldweergave, geen testbewijs.
Het probleem is opgelost wanneer de server wordt afgesloten zonder op dezelfde eenheid te wachten, normaal opstart en de service of mount werkt. Als de logbestanden abrupt eindigen of kernel-, controller- of hardwarefouten bevatten, bewaar ze dan en onderzoek het probleem met SUSE of de hardwareleverancier in plaats van time-outs aan te passen.
Voor meer informatie over de commando's, zie de SLES 15 SP7 systemd-handleiding en de SUSE-handleiding voor persistente logboeken en journalctl-filters . Deze stappen identificeren mogelijke blokkades; de juiste oplossing voor de service, het bestandssysteem of de hardware hangt af van de eenheid die in de logboeken van de machine zelf wordt genoemd.