Home
» Hoe
»
Ubuntu Server opstarten in noodmodus: een stapsgewijze handleiding voor noodgevallen
Ubuntu Server opstarten in noodmodus: een stapsgewijze handleiding voor noodgevallen
Illustratief scenario: Casey beheert een hypothetische Ubuntu Server VM die na een herstart in de noodmodus terechtkomt, kort nadat een optioneel data-volume is toegevoegd /etc/fstab. Casey heeft consoletoegang, maar geen SSH-sessie. De wijziging van het data-volume is een aanwijzing, maar geen bewezen oorzaak: de noodmodus kan na meerdere opstartfouten optreden, dus Casey controleert de logboeken van de huidige machine voordat hij iets wijzigt. De onderstaande terminalvensters tonen representatieve lay-outs en voorbeelduitvoer, geen echte reparatie of test.
Wat noodmodus inhoudt
Bij een Ubuntu Server-installatie met systemd emergency.targetstart een minimale shell op de hoofdconsole. Deze is beperkter dan de standaard shell rescue.target, die het basissysteem en de systeemmounts met alleen essentiële services opstart. Afhankelijk van het pad naar de noodmodus kan het rootbestandssysteem al alleen-lezen of lees-schrijfbaar zijn gemount. Controleer dit in plaats van een van beide statussen aan te nemen. Zie de officiële systemd-documentatie voor speciale targets .
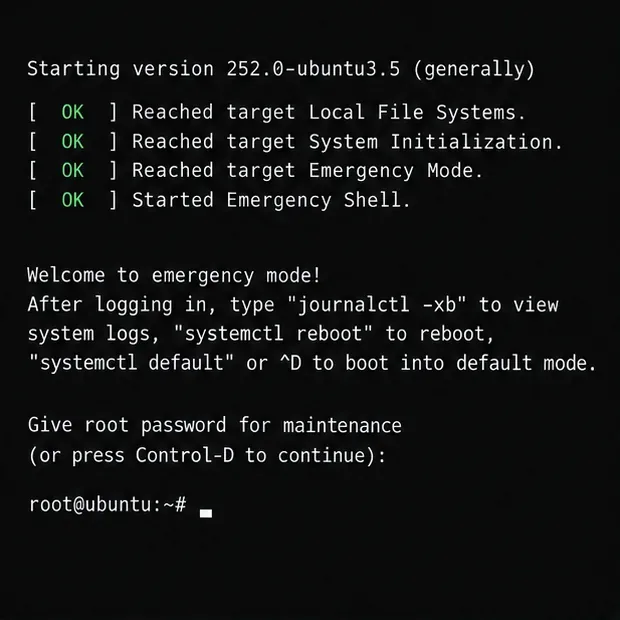
Onderscheid eerst de prompt. Een systemd-noodshell geeft doorgaans de melding "Welkom in de noodmodus!" en kan om het root-wachtwoord vragen voor onderhoud. Een BusyBox-prompt zoals (initramfs)betekent dat het opstarten nog niet is overgeschakeld naar het geïnstalleerde root-bestandssysteem; een grub>of grub rescue>prompt duidt op een probleem met de bootloader. Deze vereisen verschillende herstelprocedures. Als het root-account is vergrendeld of de server zich op afstand bevindt, gebruik dan de seriële/VNC-console of de herstelomgeving van de hostingprovider; SSH is in dit stadium meestal niet beschikbaar. Druk niet op Ctrl+D om verder te gaan totdat u de gemelde fout begrijpt en hebt opgelost.
Stapsgewijze redding
1. Behoud de consoletoegang en noteer de exacte foutmelding.
Blijf in de noodconsole. Noteer de laatst mislukte mount of servicenaam en elk apparaatpad of UUID dat boven de prompt wordt weergegeven. De recente fstabbewerking van Casey is het bekijken waard, maar zet niet elke mislukte regel in commentaar en voer geen reparatieopdracht uit die alleen gebaseerd is op het woord 'noodgeval'. Als het systeem een virtuele machine is, houd dan de providerconsole open tijdens de reparatie en de volgende herstart.
De console identificeert de noodmodus van systemd en biedt een onderhoudsshell; authenticatie en bewoordingen kunnen per configuratie verschillen.
2. Lees het huidige opstartlogboek en de defecte eenheden.
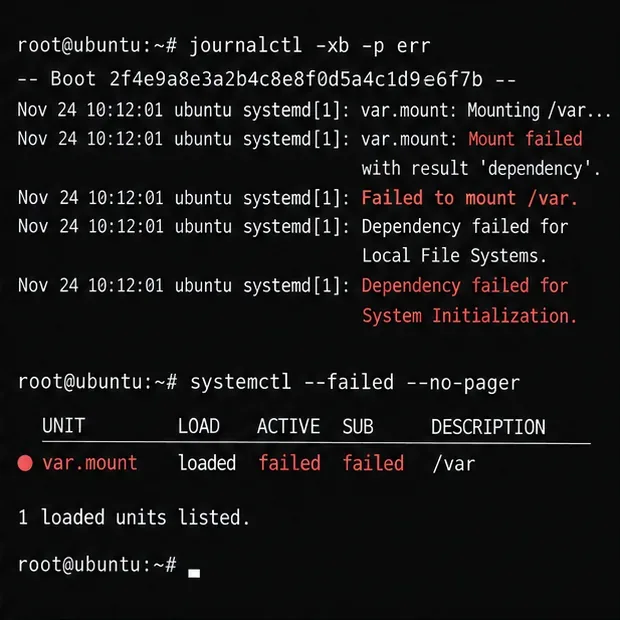
-bBeperkt de logboekquery tot deze opstartprocedure en -p errfiltert op foutprioriteit en hoger. Zoek naar de eerste relevante fout, niet alleen naar de laatste reeks 'afhankelijkheid mislukt'-berichten. Als een mount-eenheid is mislukt, noteer dan de ontsnapte eenheidsnaam en het doelpad; als een service is mislukt, identificeer dan of dit de oorzaak of slechts een gevolg is van een ontbrekende mount. journalctl(1)De handleiding van Ubuntu beschrijft het filteren op opstart- en eenheidsniveau.
De uitvoer van het opstartlogboek wijst op een mislukte mount-afhankelijkheid; de daadwerkelijke eenheidsnaam en het bericht moeten van de server komen.
3. Controleer de root-mount en de beschikbare ruimte.
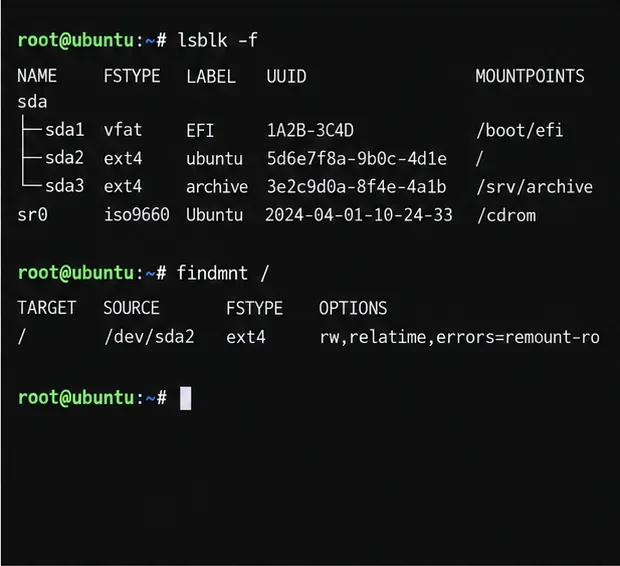
Voordat u bestanden bewerkt of reparaties probeert uit te voeren, controleer dan hoe het rootbestandssysteem is aangekoppeld en of het systeem geen blokken of inodes meer beschikbaar heeft:
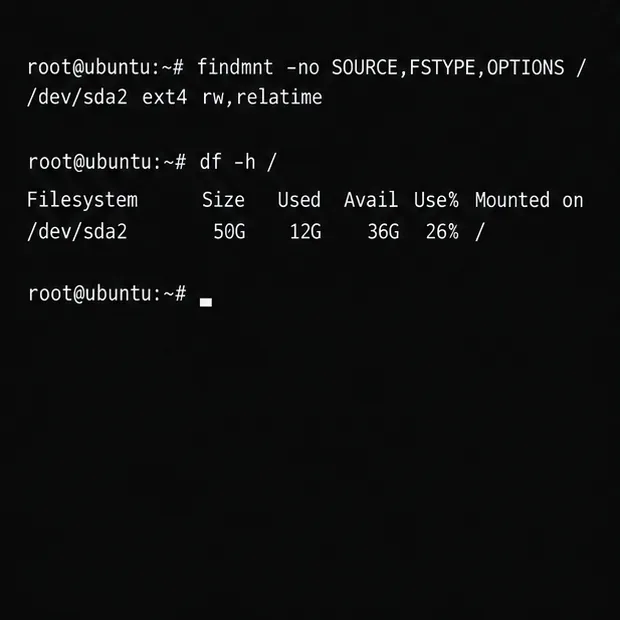
In de findmntuitvoer robetekent alleen-lezen en rwbetekent lezen-schrijven. Een alleen-lezen root kan opzettelijk zijn tijdens een herstelproces, of het kan wijzen op problemen met het bestandssysteem. Forceer niet direct een herkoppeling naar lezen-schrijven als de kernellogboeken I/O- of bestandssysteemfouten melden. Een vol bestandssysteem of een uitgeputte inodetabel kan er ook voor zorgen dat andere services en koppelingen mislukken. De Ubuntu- findmnt(8)handleiding beschrijft hoe u gekoppelde bestandssystemen kunt inspecteren.
De commando's laten zien of de root-partitie alleen-lezen of lees-schrijfbaar is aangekoppeld en of er schijfblokken beschikbaar zijn.
4. Valideer /etc/fstaben verifieer apparaat-ID's
Omdat Casey onlangs is gewijzigd /etc/fstab, controleer zowel de syntaxis als of de genoemde apparaten bestaan:
findmnt --verify --verbose
lsblk -f
blkid
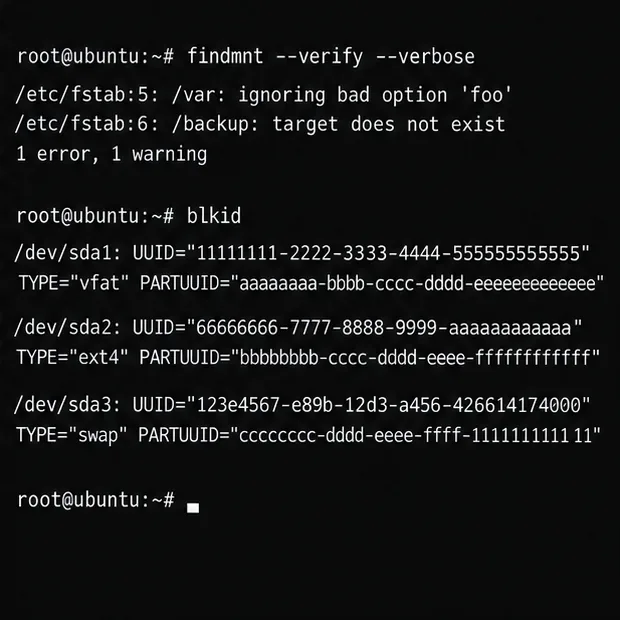
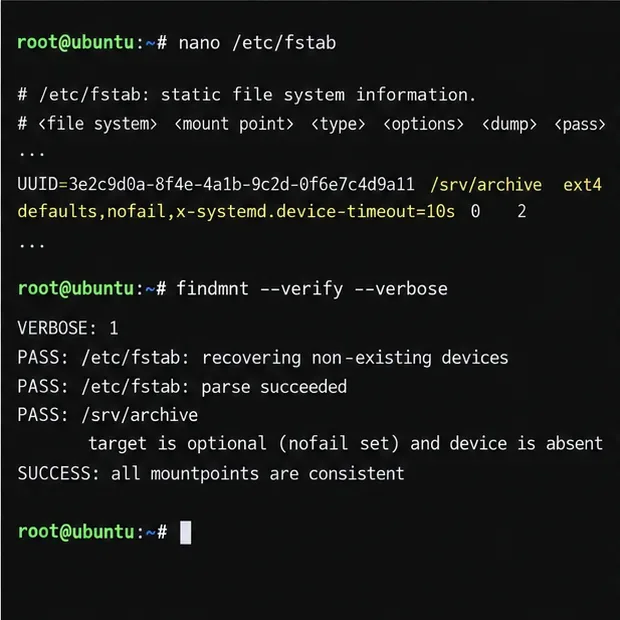
findmnt --verify --verboseControleert de fstab-vermeldingen op parseer- en bruikbaarheidsproblemen. Vergelijk elke vermelding UUID=in de verdachte regel met de UUID die wordt weergegeven door lsblk -fof blkid. Controleer ook het mountpunt, het bestandssysteemtype en de opties. Een gekopieerde UUID van een andere schijf, een apparaat dat niet is aangesloten of een ongeldige optie kan voorkomen dat een vereiste mount wordt voltooid. Raad geen partitie zoals /dev/sda1; apparaatnamen kunnen veranderen tussen opstartmomenten.
De validator meldt problemen met fstab, terwijl blkid een lijst met apparaat-UUID's opgeeft om te vergelijken met de verdachte vermelding.
5. Corrigeer alleen het bevestigde montageprobleem.
Als het rootbestandssysteem beschrijfbaar is en de fstab-controle een ongeldige regel detecteert, maak dan een back-up voordat u gaat bewerken:
cp -a /etc/fstab /etc/fstab.before-rescue
nano /etc/fstab
Corrigeer de UUID of een ander veld pas nadat u het beoogde apparaat hebt bevestigd. Als de mount daadwerkelijk optioneel is en de server nog steeds moet opstarten wanneer dat volume ontbreekt, kan een fstab-regel die rekening houdt met systemd nofaileen eindige wachttijd voor het apparaat inhouden, bijvoorbeeld:
Vervang de placeholder door de echte UUID en gebruik het daadwerkelijke bestandssysteemtype. Voeg dit niet toe nofailaan root, boot of andere bestandssystemen die nodig zijn voor de correcte werking van de machine of de applicaties. Met deze optie nofailgaat het opstarten door, zelfs als het mounten mislukt, dus afhankelijke services hebben mogelijk nog steeds aandacht nodig. De handleiding van Ubuntu systemd mount-unit beschrijft deze fstab-opties.
Na het bewerken, controleer de gegevens opnieuw voordat u probeert te koppelen:
findmnt --verify --verbose
systemctl daemon-reload
mount /srv/archive
Gebruik het daadwerkelijke koppelpunt in de laatste opdracht. Als het nog steeds mislukt, lees dan de nieuwe foutmelding en controleer of de schijf is aangesloten en in goede staat verkeert. Als het rootbestandssysteem alleen-lezen is, forceer dan geen wijzigingen zonder overleg; gebruik een herstelomgeving van de provider of opstartbare Ubuntu-media om het geïnstalleerde systeem veilig te inspecteren en te bewerken.
Het voorbeeld markeert alleen een niet-essentiële archiefmount als optioneel en controleert vervolgens het fstab-bestand.
6. Onderzoek een mislukte service alleen als het logboek ernaar verwijst.
De noodmodus betekent niet dat elke mislukte service de opstartstop heeft veroorzaakt. Als de betreffende foutmelding een service noemt, inspecteer dan die service en de bijbehorende logbestanden in plaats van deze te maskeren of uit te schakelen:
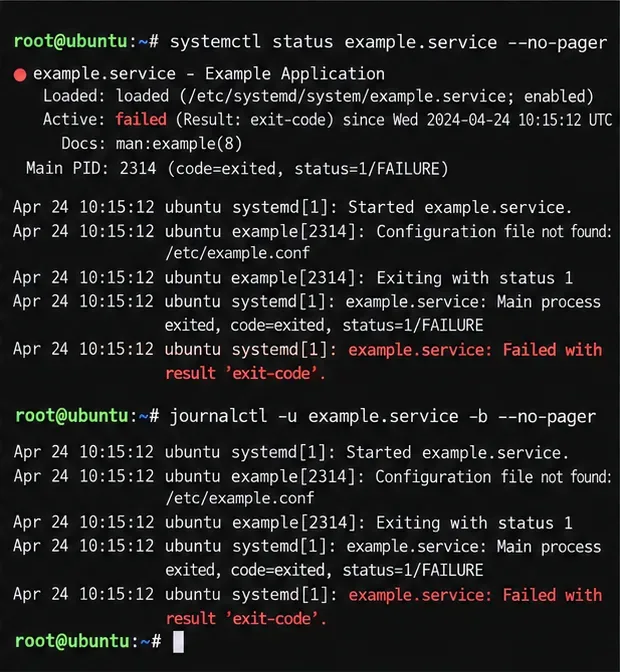
systemctl status example.service --no-pager
journalctl -u example.service -b --no-pager
Vervang dit example.servicedoor de exacte eenheidsnaam. Controleer of het configuratiebestand, het uitvoerbare bestand, de inloggegevens of de vereiste mount ontbreekt. Als de fout zich voordoet na het ontbreken van het datavolume van Casey, herstel dan eerst die mount en evalueer de service vervolgens opnieuw. Het uitschakelen van een essentiële service kan het symptoom maskeren, terwijl de server onbruikbaar blijft.
De servicestatus en het logboek helpen bij het onderscheiden van de hoofdoorzaak van storingen die worden veroorzaakt door een andere ontbrekende afhankelijkheid.
7. Behandel bestandssysteemfouten als een offline reparatietaak.
Als het kerneljournaal melding maakt van beschadiging van het bestandssysteem of I/O-fouten met de opslag, stop dan waar mogelijk met schrijven en maak een back-up of snapshot van de provider voordat u de reparatie uitvoert. Controleer het exacte apparaat en bestandssysteem met lsblk -f. Voor een root-bestandssysteem start u op in het herstelsysteem van de provider of de Ubuntu-herstel-/livemedia, zorgt u ervoor dat de betreffende partitie is ontkoppeld en gebruikt u de juiste checker voor dat bestandssysteem. Voor ext2/3/4 is dat e2fsck; voor XFS, Btrfs en andere formaten gelden andere procedures.
Voer nooit fsckcommando's uit e2fsckop een aangekoppeld bestandssysteem, inclusief een aangekoppelde, alleen-lezen root. De Ubuntu- e2fsck(8)handleiding waarschuwt dat het controleren van een aangekoppeld bestandssysteem over het algemeen onveilig is en dat de resultaten niet geldig zijn. Als de schijf herhaaldelijk I/O-fouten meldt, geef dan prioriteit aan het herstellen van gegevens of het inschakelen van de opslagprovider boven het herhaaldelijk proberen de schijf te repareren.
De schijflijst helpt bij het identificeren van de juiste partitie; het rootbestandssysteem blijft aangekoppeld, dus het is nog niet klaar voor fsck.
8. Keer terug naar de normale opstartprocedure en controleer het resultaat.
Zodra de vastgestelde oorzaak is verholpen, start u het apparaat opnieuw op via de console:
systemctl reboot
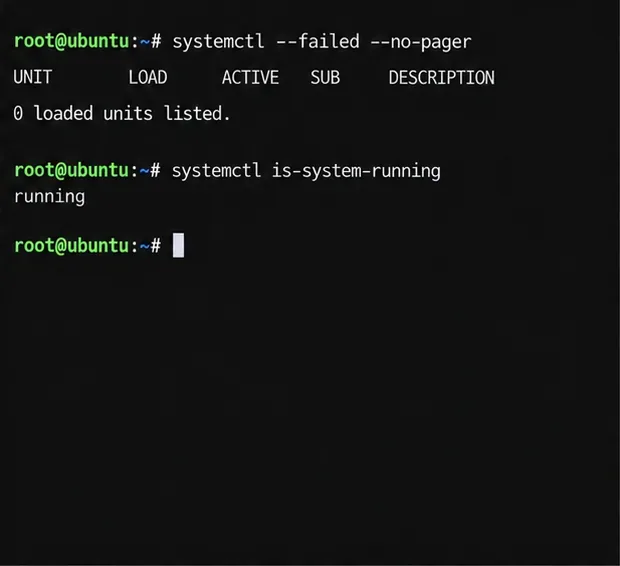
Controleer na het opstarten van Ubuntu de geconfigureerde standaarddoelserver, de huidige systeemstatus, de mislukte eenheden en de nieuwe opstartprocedure:
Als u er bewust voor kiest om door te gaan in de huidige opstartmodus, systemctl defaultvraagt u systemd om het geconfigureerde standaarddoel te starten. Gebruik dit alleen nadat de blokkerende fout is verholpen; het herstelt geen ongeldige mount of beschadigd bestandssysteem. systemctl get-defaultHet toont het geconfigureerde standaarddoel; systemctl is-system-runninghet rapporteert of systemd de huidige status als actief, verslechterd of anderszins beschouwt. Een succesvol herstel betekent dat de verwachte bestandssystemen zijn gemount, de vereiste services actief zijn en dat dezelfde noodsituatie zich na een herstart niet opnieuw voordoet.
De terminal toont de systemctl-controles op mislukte eenheden en of het systeem na de herstart nog steeds werkt.
Als de prompt (initramfs)in plaats daarvan is
Voer de stappen voor de noodshell van systemd niet blindelings uit in de initramfs van BusyBox. De initramfs-fase probeert het daadwerkelijke root-bestandssysteem te vinden en te mounten voordat de controle wordt overgedragen aan het geïnstalleerde systeem. Noteer de exacte foutmelding, controleer of het verwachte apparaat in de /devlijsten voorkomt /dev/disk/by-uuiden vergelijk de waarde in de opstartopdrachtregel root=met de daadwerkelijke root-UUID. Als de schijf of het versleutelde/LVM-volume ontbreekt, gebruik dan de opslag- en hersteltools van de provider om dit te onderzoeken. Het opnieuw opbouwen van de initramfs of het wijzigen van GRUB-parameters zonder het ontbrekende apparaat te identificeren, kan het herstelproces bemoeilijken.
Voor Casey's hypothetische VM is het nuttige resultaat een geverifieerde oorzaak en een gerichte correctie: herstel het verwachte optionele volume, corrigeer de bevestigde identificatiecode ervan, of configureer het alleen als optioneel als de werklast dat daadwerkelijk toelaat. Controleer vervolgens de volgende opstart vanaf de console voordat de herstelsessie wordt afgesloten.