Home
» Technologie
»
Halfgeleiders van de volgende generatie: hoe AI en supercomputing verder gaan dan kleinere transistors
Halfgeleiders van de volgende generatie: hoe AI en supercomputing verder gaan dan kleinere transistors
Het korte antwoord: de vooruitgang op het gebied van AI komt nu voort uit het gehele halfgeleidersysteem.
De volgende generatie AI- en supercomputerhardware wordt niet aangedreven door één enkele doorbraak. Het wordt opgebouwd uit verschillende technologieën die naadloos op elkaar aansluiten: gate-all-around transistors, stroomvoorziening aan de achterzijde, chiplet-architecturen, geavanceerde verpakkingstechnologie, geheugen met hoge bandbreedte, snellere verbindingen tussen chips en steeds vaker optische netwerken. Het praktische resultaat is meer rekenkracht, een grotere geheugenbandbreedte en betere schaalbaarheid, zonder alleen afhankelijk te zijn van kleinere transistorafmetingen.
Dat is belangrijk omdat moderne AI-acceleratoren en wetenschappelijke supercomputers vaak tegen de limieten van dataverwerking en rekenkracht aanlopen voordat ze hun pure rekenkracht bereiken. Een snellere matrixengine is alleen nuttig als modelgewichten, activaties en tussenresultaten deze snel genoeg kunnen bereiken. Evenzo is het toevoegen van meer acceleratoren alleen nuttig als de behuizing, het racknetwerk, het geheugensysteem, het koelsysteem en de softwarestack ze allemaal aankunnen.
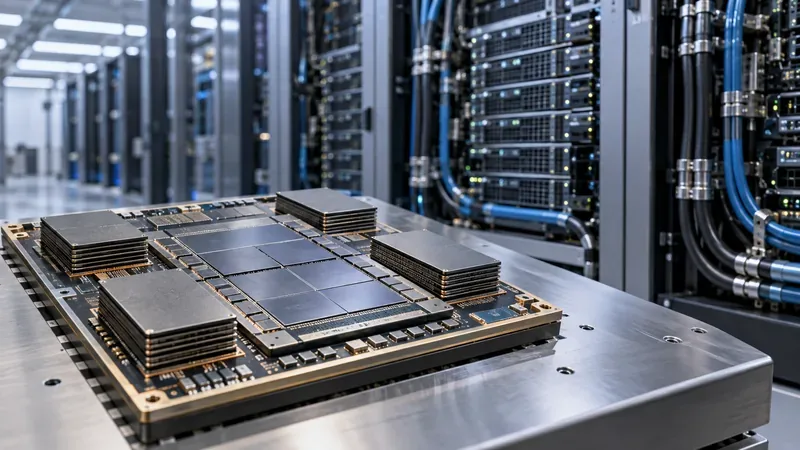
Een multi-chip acceleratormodule met meerdere gestapelde geheugenpakketten illustreert de richting van moderne AI-hardware: rekenkracht, geheugen, behuizing, stroomvoorziening en koeling worden steeds vaker als één systeem ontworpen.
1. Nieuwe transistorstructuren verbeteren de efficiëntie, maar ze vormen slechts het begin.
De nieuwste logica gaat verder dan de FinFET-structuur die jarenlang de boventoon voerde in geavanceerde chips. Gate-all-around (GAA)-ontwerpen wikkelen de gate rond een nanosheet of een vergelijkbare kanaalstructuur, waardoor chipontwerpers een nauwkeurigere elektrostatische controle krijgen naarmate de componenten kleiner worden. Dit kan de prestaties verbeteren, lekstroom verminderen of een betere balans tussen beide bieden.
TSMC meldt dat de massaproductie van zijn 2-nanometer N2-proces in het vierde kwartaal van 2025 van start gaat, terwijl de A16-technologie nanosheet-transistoren combineert met een voedingsrail aan de achterzijde, met name gericht op krachtige computerproducten met een hoge stroomvoorzieningsbehoefte. TSMC heeft aangegeven dat de massaproductie van A16 gepland staat voor de tweede helft van 2026. Zie de pagina over de A16-technologie van de chipfabrikant en het jaarverslag van 2025 .
Intel volgt een vergelijkbare richting met Intel 18A. Het productieproces combineert RibbonFET GAA-transistoren met PowerVia-voeding aan de achterzijde. Intel meldt dat 18A in 2025 in productie is gegaan, terwijl de verbeterde 18A-P-versie in juni 2026 in risicoproductie is gegaan. Intel publiceert ook vergelijkende prestatie-, energie- en dichtheidscijfers voor het productieproces; deze cijfers zijn door de fabrikant zelf gerapporteerd en moeten worden gevalideerd aan de hand van een specifiek ontwerp in plaats van te worden beschouwd als universele verbeteringen op chipniveau. De actuele details zijn te vinden op de Intel 18A-procespagina .
Voeding aan de achterkant is belangrijk omdat geavanceerde chips zowel signalen als stroom door extreem dichte bedrading moeten leiden. Door een deel van het voedingsnetwerk naar de achterkant te verplaatsen, kunnen er routingbronnen aan de signaalzijde vrijkomen en de spanningslevering worden verbeterd. Voor AI-acceleratoren, waar grote arrays van rekeneenheden met hoge snelheden schakelen, kan dit net zo belangrijk zijn als de transistordichtheid.
2. Chiplets en geavanceerde verpakkingstechnologieën maken van een verpakking een klein computersysteem.
Monolithische chips worden steeds moeilijker en duurder om op te schalen naarmate ze groter worden. Chiplets bieden een alternatief: afzonderlijke functies kunnen worden geproduceerd met procestechnologieën die er het beste bij passen, en vervolgens in één behuizing worden samengevoegd. Een rekenchip heeft mogelijk de meest geavanceerde logische processen nodig, terwijl I/O, cache, analoge circuits of andere functies dat misschien niet nodig hebben.
De verpakking maakt dit praktisch. Het geavanceerde verpakkingsplatform CoWoS van TSMC is bijvoorbeeld ontworpen om meerdere logische apparaten en stapels high-bandwidth geheugen te integreren in een 2,5D-pakket. TSMC positioneert CoWoS specifiek voor AI- en HPC-producten, waar korte, brede verbindingen tussen de rekenkracht en het high-bandwidth geheugen cruciaal zijn.
Er ontstaan ook standaarden om chiplets minder proprietair te maken. De UCIe 3.0-specificatie , die in augustus 2025 wordt uitgebracht, ondersteunt datasnelheden van 48 GT/s en 64 GT/s en voegt functies toe voor energie-efficiëntie, beheersbaarheid en flexibelere multi-chipsystemen. UCIe maakt chiplets niet van de ene op de andere dag uitwisselbaar, maar het biedt de industrie wel een gemeenschappelijk elektrisch en protocolkader voor verbindingen binnen de chip.
Deze aanpak is vooral aantrekkelijk wanneer een bedrijf verschillende varianten van een accelerator wil bouwen met herbruikbare bouwstenen. Het is minder aantrekkelijk wanneer de kosten van de behuizing, de thermische dichtheid of de complexiteit van het ontwerp zwaarder wegen dan het voordeel van modulariteit. Een kleiner product met bescheiden geheugen- en I/O-behoeften kan nog steeds beter gediend zijn met een eenvoudiger, monolithisch apparaat.
3. Hoogbandbreedtegeheugen wordt net zo strategisch als de accelerator zelf.
AI-workloads verplaatsen herhaaldelijk grote tensors tussen geheugen en rekeneenheden. Daardoor is de geheugenbandbreedte een cruciale ontwerpbeperking. High-bandwidth memory, of HBM, lost dit probleem op door DRAM-chips op elkaar te stapelen en ze fysiek dicht bij de accelerator te plaatsen via een zeer brede interface.
HBM4 is nu niet langer alleen een roadmap, maar wordt ook daadwerkelijk in commerciële systemen gebruikt. Samsung kondigde in februari 2026 de start van commerciële HBM4-leveringen aan en gaf aan dat het product in massaproductie gaat met een aanhoudende overdrachtssnelheid van 11,7 Gb/s, met een maximale capaciteit van 13 Gb/s. In mei 2026 kondigde Samsung ook de levering van HBM4E-samples aan. Deze details zijn te vinden in de aankondiging van Samsung over de HBM4-productie .
SK hynix meldde in zijn resultaten over het tweede kwartaal van 2026 dat het in dat kwartaal is begonnen met de massale levering van HBM4 en dat het van plan is de productie in de tweede helft van het jaar op te voeren. Het bedrijf heeft ook monsters van 12-laags HBM4E verzonden. Raadpleeg de resultaten van SK hynix over het tweede kwartaal van 2026 voor de actuele status.
Waarom is dit in de praktijk belangrijk? De huidige specificaties van NVIDIA's Vera Rubin vermelden 288 GB HBM4 op één Rubin GPU en een GPU-geheugenbandbreedte van 19,2 TB/s. Ter vergelijking: AMD's MI350-serie accelerators gebruiken HBM3E; AMD vermeldt tot 288 GB en 8 TB/s voor de MI355X. Dit zijn verschillende architecturen en zouden niet alleen op basis van één bandbreedtecijfer vergeleken moeten worden, maar beide illustreren hoe geheugencapaciteit en bandbreedte nu essentiële specificaties voor accelerators zijn in plaats van secundaire details. Zie de officiële NVIDIA Vera Rubin NVL72-specificaties en de AMD Instinct MI350-seriepagina .
4. De interconnecties voor opschaling en uitschaling bepalen of meerdere versnellers als één geheel functioneren.
Grote modellen en wetenschappelijke simulaties passen zelden netjes op één apparaat. Het systeem moet het werk verdelen over meerdere versnellers en regelmatig tussentijdse resultaten uitwisselen. Als de communicatie traag is, staan dure rekeneenheden ongebruikt.
Daarom ontwikkelen eigen schaalbare fabrics zich parallel aan de GPU's zelf. NVIDIA's Rubin-platform maakt gebruik van de zesde generatie NVLink; NVIDIA geeft een NVLink-bandbreedte van 3 TB/s per Rubin GPU op en 216 TB/s voor een NVL72-systeem. AMD gebruikt Infinity Fabric voor al zijn acceleratorplatforms. Voor kopers is de belangrijkste vraag niet alleen de piekbandbreedte, maar ook hoe de fabric zich gedraagt onder de exacte collectieve bewerkingen, modelparallelle patronen en topologie die door de applicatie worden gebruikt.
Ook op het niveau van het systeemgeheugen is Compute Express Link in ontwikkeling. Het CXL Consortium meldt dat CXL 4.0 de signaalsnelheid verdubbelt van 64 GT/s naar 128 GT/s, gebundelde poorten toevoegt en de betrouwbaarheidsfuncties van het geheugen uitbreidt. CXL is relevant wanneer architecten een coherente geheugenuitbreiding, -pooling of -disaggregatie willen realiseren zonder elke geheugenlaag als een extern opslagapparaat te behandelen.
5. Siliciumfotonica komt steeds dichter bij schakelend silicium.
Koper blijft uitstekend geschikt voor korte, dichte elektrische verbindingen, maar optische verbindingen worden steeds aantrekkelijker naarmate de afstand en de totale bandbreedte toenemen. Een belangrijke volgende stap is co-packaged optics, waarbij optische componenten dichter bij de netwerk-ASIC worden geplaatst in plaats van volledig in plugbare transceivers aan de rand van een switch te zitten.
NVIDIA stelt dat zijn Spectrum-X Ethernet Photonics-platform gebruikmaakt van geïntegreerde optische componenten en een tot wel vijf keer hogere energie-efficiëntie van het netwerk biedt dan traditionele ontwerpen met insteekbare transceivers. Dit is een vergelijking tussen leveranciers en geen garantie voor elke datacentertopologie, maar het geeft wel de richting aan: energiegebruik in het netwerk wordt steeds belangrijker, waardoor optische integratie nu onderdeel uitmaakt van het ontwerp van halfgeleidersystemen. Zie het overzicht van NVIDIA over siliciumfotonica .
Wat dit betekent voor daadwerkelijke AI- en supercomputertaken.
Werkdruk
Eigenschappen van halfgeleiders die prioriteit moeten krijgen
Waarom ze belangrijk zijn
Pretraining van grote modellen
HBM-capaciteit en -bandbreedte, snelle opschaling van verbindingen, compacte behuizing, krachtige koeling
De training richt zich voornamelijk op tensorbeweging en gesynchroniseerde communicatie tussen meerdere versnellers.
Lange context en agentische gevolgtrekking
Grote HBM-pools, efficiënte berekeningen met lage precisie, hoge interconnect-bandbreedte, geheugentiering
KV-cache en herhaalde redeneerstappen kunnen de geheugencapaciteit en gegevensverplaatsing beperkender maken dan de maximale FLOPS.
Modulariteit kan de hergebruikcycli verkorten, maar de complexiteit van de verpakking en de kwalificatie van de toeleveringsketen kunnen dit voordeel tenietdoen.
Een concreet voorbeeld: waarom een snellere GPU niet genoeg is.
Stel je een team voor dat een groot taalmodel met lange contextvensters gebruikt. Stel dat profilering aantoont dat GPU's vaak wachten op geheugentransfers en communicatie tussen GPU's. Overstappen naar een nieuwere accelerator zou kunnen helpen, maar alleen als het nieuwe systeem ook voldoende HBM-capaciteit, een snellere geheugenbandbreedte en een topologie biedt die communicatievertragingen vermindert. De aanschaf van een apparaat met hogere theoretische tensorprestaties, terwijl de knelpunten in geheugen en netwerk hetzelfde blijven, levert mogelijk veel minder verbetering op dan de specificaties doen vermoeden.
Hetzelfde principe zien we terug in traditionele supercomputers. Het Frontier-systeem van het Oak Ridge National Laboratory combineert AMD MI250X-acceleratoren met HBM en een snelle systeeminterconnect. De gebruikershandleiding van Frontier beschrijft hoe de rekenkracht, HBM, CPU-GPU-verbindingen en het Slingshot-netwerk samenwerken. De hardwaregeneratie is ouder dan de nieuwste AI-platforms van 2026, maar de architectonische les is nog steeds relevant: duurzame applicatieprestaties zijn afhankelijk van de verbinding tussen rekenkracht, geheugen en andere knooppunten.
Wanneer is de upgrade naar de volgende generatie halfgeleiderhardware de moeite waard?
Een upgrade is het best te verdedigen wanneer deze een meetbaar knelpunt oplost in plaats van simpelweg een ouder onderdeel te vervangen. Controleer het volgende voordat u overgaat op een nieuwe generatie acceleratoren:
Geheugenbelasting: Wordt het model of de simulatie naar het hostgeheugen overgeheveld, zijn er agressieve checkpoints nodig of wordt een onhandige mate van modelpartitionering afgedwongen?
Bandbreedtedruk: Zijn kernels geheugengebonden tijdens het profileren, of besteden accelerators aanzienlijke tijd aan het wachten op all-reduce en andere collectieve bewerkingen?
Stroomvoorziening en koeling: kunnen het serverrack, de faciliteit en het koelsysteem de nieuwe vermogensdichtheid aan? Hogere prestaties hoeven nog steeds geen goede oplossing te zijn als de kosten voor infrastructuurupgrades de overhand hebben.
Softwaregereedheid: Zijn de compiler, bibliotheken, kernels, orchestratiestack en monitoringtools klaar voor de nieuwe architectuur?
Precisievereisten: Kan de workload veilig gebruikmaken van formaten met een lagere precisie, of is FP64 of een andere methode met hogere precisie vereist?
Gebruikswaarde: Zal de werkbelasting de nieuwe hardware voldoende bezighouden om de kosten te rechtvaardigen? Capaciteit die niet gebruikt wordt, wordt niet rendabel omdat de chip nieuwer is.
De compromissen worden steeds fysieker.
De vooruitgang in halfgeleidertechnologie levert indrukwekkende mogelijkheden op, maar de beperkende factoren worden steeds tastbaarder. Geavanceerde behuizingen zijn groter en moeilijker te produceren. HBM-stacks concentreren warmte in de buurt van krachtige logica. Racksystemen kunnen vloeistofkoeling, een dichte stroomverdeling en gespecialiseerde netwerken vereisen. Geïntegreerde optische componenten kunnen het netwerkvermogen verminderen, maar brengen nieuwe overwegingen met zich mee op het gebied van productie en onderhoud. Chiplets kunnen de modulariteit verbeteren, maar brengen extra werk met zich mee op het gebied van validatie, verpakking en opbrengstbeheer.
Er is ook een afweging op softwaregebied. Rekenen met lage precisie, zoals FP8, FP6 of FP4, kan de doorvoer van AI aanzienlijk verhogen, maar de software moet de modelkwaliteit behouden. Wetenschappelijke codes kunnen mogelijk niet dezelfde snelkoppelingen gebruiken. Een halfgeleidereigenschap is alleen waardevol als de applicatiestack deze kan benutten zonder de nauwkeurigheids- of betrouwbaarheidseisen te schenden.
Wat je hierna kunt kijken
Voor de rest van 2026 en in 2027 zijn de meest nuttige signalen niet alleen nieuwe namen voor chipfabricageknooppunten. Let op of TSMC's A16-procestechnologie en Intels 18A-familieprocessen breed worden toegepast in consumentenproducten; hoe snel HBM4 en HBM4E op grote schaal beschikbaar komen; of UCIe 3.0 zorgt voor zinvolle interoperabiliteit tussen chiplets van verschillende leveranciers; waar CXL 4.0 in productiesystemen verschijnt; en of co-packaged optica economisch en onderhoudbaar blijkt te zijn op grote schaal.
Deze mijlpalen zullen uitwijzen of de halfgeleiderindustrie AI en supercomputing kan blijven opschalen zonder dat geheugenverplaatsing, stroomvoorziening, netwerken en koeling de winst die behaald is met dichtere logica tenietdoen.
Kortom
De toekomst van AI en supercomputing wordt minder aangedreven door één enkele "volgende node" en meer door gecoördineerde halfgeleidertechnologie. GAA-transistoren en backside power verbeteren de logische basis. Chiplets en geavanceerde verpakkingstechnologieën stellen ontwerpers in staat grotere systemen te bouwen dan een enkele chip comfortabel kan bieden. HBM4 voedt accelerators met een extreem hoge bandbreedte. UCIe, CXL, NVLink, Infinity Fabric en optische netwerken verplaatsen data over steeds grotere domeinen.
Bij de keuze van hardware moet u beginnen met de werkelijke bottleneck van uw workload. Voor geheugenintensieve AI moet u prioriteit geven aan HBM-capaciteit en bandbreedte. Voor gedistribueerde training moet u prioriteit geven aan de schaalbaarheid (zowel op- als uitbreidbaar). Voor wetenschappelijke berekeningen moet u de FP64-prestaties en de bibliotheekprestaties controleren. Voor implementaties in een bedrijfsomgeving moet u rekening houden met stroomverbruik, koeling, softwareondersteuning en de benodigde integratietijd. De snelste halfgeleider op papier is niet automatisch het snelste of meest economische systeem voor uw workload.