Home
» Technologie
»
Wat veroorzaakt wijdverspreide uitval van cloudplatformen? De faalpatronen achter grote storingen.
Wat veroorzaakt wijdverspreide uitval van cloudplatformen? De faalpatronen achter grote storingen.
Wijdverspreide downtime van cloudplatformen wordt zelden veroorzaakt door één enkele server die simpelweg "uitvalt". De meest ontwrichtende incidenten beginnen meestal met één technische fout – een verkeerde configuratie, een softwarefout, een DNS-probleem, een netwerkstoring of een infrastructuurincident – en verspreiden zich vervolgens omdat veel services afhankelijk zijn van dezelfde controlelagen, databases, identiteitssystemen, loadbalancers of regionale resources.
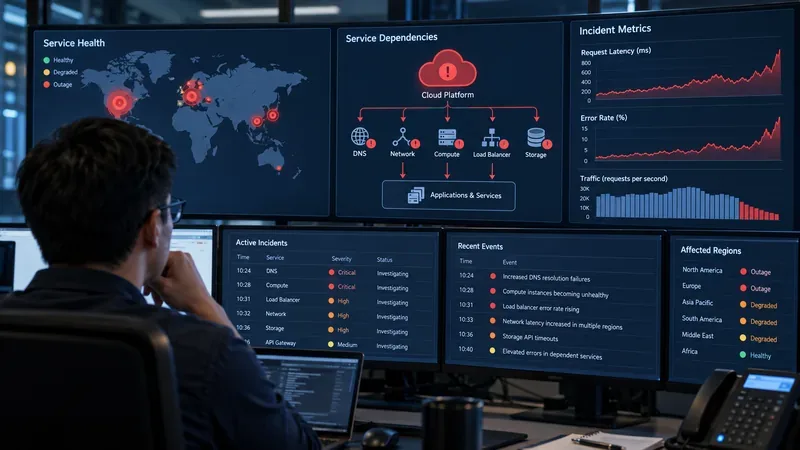
Illustratief scenario: stel je een fictieve cloudprovider voor, genaamd Northstar Cloud. Om 10:05 uur wordt een geautomatiseerde netwerkwijziging doorgevoerd in een regionale service. Binnen enkele minuten melden klanten mislukte API-aanroepen. Om 10:12 uur starten er geen nieuwe virtuele machines meer op. Om 10:20 uur beginnen loadbalancers gezonde backends als niet beschikbaar te markeren. Tegen 10:35 uur vertonen tientallen ogenschijnlijk ongerelateerde producten problemen. Dit scenario is hypothetisch en beschrijft geen echte storing. Het is nuttig omdat het laat zien hoe een kleine initiële fout kan uitgroeien tot een grote platformstoring.
Cloudbeheerteams moeten vaak de oorzaak van een storing achterhalen, van de eerste falende component tot aan DNS, netwerken, rekenkracht, load balancing, opslag en downstream-applicaties.
Het korte antwoord: grote cloudstoringen zijn meestal domino-effecten.
De belangrijkste oorzaken van wijdverspreide uitval van cloudplatformen zijn configuratie- en implementatiefouten, verborgen softwarefouten, DNS- en routeringsfouten, afhankelijkheden van gedeelde services, capaciteitsuitputting tijdens een storing of herstel, problemen met het besturingsvlak en fysieke storingen die een datacenter of beschikbaarheidszone treffen. De omvang van de uitval hangt minder af van de eerste fout dan van hoe wijdverspreid het getroffen onderdeel is.
Een nuttig praktijkvoorbeeld komt van AWS. In het officiële verslag na de storing in Noord-Virginia in oktober 2025 meldde AWS dat een latente raceconditie in het geautomatiseerde DNS-beheersysteem van DynamoDB een onjuist, leeg DNS-record voor het regionale eindpunt had gegenereerd. Deze DNS-fout trof klanten en interne AWS-services die afhankelijk waren van DynamoDB, en de daaropvolgende herstelwerkzaamheden droegen bij aan problemen met EC2-lanceringen en Network Load Balancers. Het incident is gedocumenteerd in het AWS-verslag na de storing in DynamoDB in oktober 2025 .
1. Configuratiewijzigingen kunnen een onverwacht grote impact hebben.
Configuratiefouten behoren tot de meest voorkomende oorzaken van incidenten in grote gedistribueerde systemen, omdat moderne platforms geautomatiseerd worden aangestuurd. Een enkele wijziging kan sneller naar duizenden hosts, routers, DNS-records of service-endpoints worden doorgevoerd dan een menselijke operator dat handmatig zou kunnen doen.
Laten we terugkeren naar het Northstar Cloud-scenario. Stel dat de netwerkwijziging van 10:05 uur bedoeld was voor tien machines, maar is toegepast op meerdere regio's. De wijziging hoeft geen hardware te beschadigen. Het kan simpelweg de bruikbare netwerkcapaciteit verminderen, de routering wijzigen of ervoor zorgen dat systemen anderszins legitiem verkeer weigeren. Zodra de gedeelde capaciteit onder de vraag daalt, ervaren klanten time-outs en herhaalde pogingen, wat de belasting verder verhoogt.
Google beschreef een vergelijkbaar mechanisme in zijn officiële verklaring over een storing in 2019: een configuratiewijziging die bedoeld was voor een klein aantal servers in één regio werd onjuist veel breder toegepast, waardoor meerdere regio's meer dan de helft van hun beschikbare netwerkcapaciteit niet meer konden gebruiken. Het verkeer zorgde vervolgens voor overbelasting van de resterende capaciteit. Zie de officiële update van Google over de servicestoring van 2019 .
Daarom gebruiken ervaren cloudproviders gefaseerde uitrol, validatie, geautomatiseerde terugdraaiing, limieten voor de wijzigingsfrequentie en beheersmaatregelen die de impact van een incident beperken. Deze beveiligingsmaatregelen sluiten incidenten niet volledig uit, maar kunnen voorkomen dat één slechte wijziging uitgroeit tot een platformwijde ramp.
2. Softwarefouten kunnen verborgen blijven totdat zich zeldzame timingomstandigheden voordoen.
Grote cloudplatformen draaien enorme hoeveelheden gedistribueerde software. Sommige defecten blijven maanden of zelfs jaren onopgemerkt omdat ze een zeldzame reeks gebeurtenissen vereisen: twee controllers die dezelfde status bijwerken, een ongebruikelijke vertraging, verouderde metadata of een herstelproces dat tegelijkertijd met een opschoonproces wordt uitgevoerd.
Stel je voor dat in het fictieve Northstar-incident twee onafhankelijke automatiseringsmedewerkers hetzelfde DNS-plan bijwerken. De ene loopt vertraging op, de andere voert een nieuwere update uit, waarna een opschoonroutine de gegevens verwijdert die de vertraagde medewerker zojuist heeft geactiveerd. Elk afzonderlijk onderdeel lijkt naar behoren te functioneren, maar hun interactie creëert een ongeldige toestand.
Het AWS DynamoDB-incident van 2025 illustreert deze categorie duidelijk. AWS schreef de aanvankelijke fout toe aan een latente raceconditie tussen redundante DNS-beheercomponenten. De betekenis hiervan reikt verder dan één leverancier: redundantie verbetert de betrouwbaarheid alleen wanneer redundante componenten de gedeelde status niet kunnen beschadigen door dezelfde logica- of synchronisatiefout.
3. DNS- en netwerkstoringen kunnen ervoor zorgen dat goed functionerende systemen onbereikbaar worden.
Een dienst kan volledig operationeel zijn en toch feitelijk ontoegankelijk als klanten de hostnaam niet kunnen oplossen of als datapakketten de dienst niet kunnen bereiken. DNS, routing, load balancing en netwerkconfiguratie vormen daarom een cruciaal onderdeel van vrijwel elk cloudproduct.
In ons Northstar-voorbeeld zouden klanten kunnen aannemen dat de rekenservice zelf is uitgevallen omdat API-aanroepen een time-out geven. Maar de rekenservers zelf kunnen wel functioneren, terwijl DNS geen bruikbaar eindpunt retourneert, een route ontbreekt of een load balancer gezonde targets heeft verwijderd.
AWS heeft deze faalmodus al vaker gedocumenteerd. Bij een incident in de regio Seoul in 2018 meldde AWS dat een configuratie-update per ongeluk een instelling had verwijderd die het minimum aantal gezonde hosts voor de EC2 DNS-resolvervloot specificeerde. De verminderde resolvercapaciteit zorgde er vervolgens voor dat DNS-query's van EC2-instanties mislukten. De details zijn te vinden in het AWS-overzicht van het EC2 DNS-resolutieprobleem in Seoul in 2018 .
Netwerkstoringen kunnen zich bovendien snel verergeren doordat applicaties mislukte verbindingen opnieuw proberen te maken. Dit agressieve herhaalpogingsgedrag kan een gedeeltelijke netwerkstoring veranderen in een veel grotere verkeerspiek.
4. Gedeelde afhankelijkheden zorgen ervoor dat niet-gerelateerde services tegelijkertijd uitvallen.
Cloudservices zijn geen op zichzelf staande producten. Een beheerde database kan afhankelijk zijn van identiteitsdiensten, interne DNS, opslag, netwerken, planningssystemen, certificeringsdiensten en telemetrie. Een serverloos platform kan afhankelijk zijn van rekenkracht, netwerken, wachtrijen en databases voor het besturingsvlak. Als één gedeelde afhankelijkheid uitvalt, kunnen veel producten tegelijkertijd minder goed functioneren.
Dit verklaart een van de meest verwarrende symptomen van een storing: klanten zien fouten in verschillende services en gaan ervan uit dat er meerdere onafhankelijke storingen zijn opgetreden. In werkelijkheid kunnen de zichtbare storingen allemaal dezelfde oorzaak hebben.
In het Northstar-scenario zouden de virtuele-machineservice, de containerservice en de serverloze service allemaal kunnen uitvallen omdat ze afhankelijk zijn van dezelfde interne resourcedatabase. De klantgerichte producten zijn verschillend; de onderliggende afhankelijkheid is dat niet.
Het AWS-incident van oktober 2025 liet dit soort cascade-effecten zien, waarbij interne services die afhankelijk waren van DynamoDB werden getroffen door het oorspronkelijke DNS-probleem, gevolgd door gevolgen voor het herstelproces in EC2, Network Load Balancer, Lambda, containerservices, identiteitsgerelateerde functies en andere producten.
5. Het herstelproces kan mislukken omdat de achterstand groter is dan de normale werkbelasting.
Het herstellen van het oorspronkelijke defecte onderdeel beëindigt een storing niet altijd. Tijdens de downtime groeien wachtrijen, verlopen leases, mislukken health checks, vragen autoscalers vervangende capaciteit aan, proberen clients verzoeken opnieuw en stapelen configuratie-updates zich op. Wanneer de defecte afhankelijkheid weer beschikbaar komt, kunnen alle wachtende systemen tegelijkertijd proberen te herstellen.
Stel in het Northstar-voorbeeld dat de DNS-problemen om 10:45 uur zijn opgelost. Duizenden rekenhosts proberen nu verlopen leases te vernieuwen. Tegelijkertijd proberen klanten mislukte implementaties opnieuw en vragen autoscaling-systemen om vervangende instanties. Het controlepaneel verwerkt plotseling een veelvoud van de normale werklast. Als er geen effectieve snelheidslimieten of herstelprioriteit zijn, kan het in een tweede foutmodus terechtkomen, zelfs als de oorspronkelijke bug is verholpen.
AWS beschreef in 2025 een vergelijkbaar herstelprobleem: nadat de toegang tot DynamoDB was hersteld, moest een EC2-subsysteem een groot aantal leases opnieuw tot stand brengen. De achterstand werd moeilijk te verwerken voordat er time-outs optraden, en AWS zei dat het subsysteem in een staat van "congestieve ineenstorting" terechtkwam. Dat detail is belangrijk omdat het laat zien waarom de duur van een storing veel langer kan zijn dan de tijd die nodig is om de oorspronkelijke oorzaak te verhelpen.
6. Gezondheidscontroles en geautomatiseerde failover kunnen soms de goede capaciteit uitschakelen.
Gezondheidscontroles zijn essentieel, maar ze fungeren ook als geautomatiseerde besluitvormers. Als een netwerk traag is of de statusinformatie vertraagd wordt doorgegeven, kan een gezondheidscontrolesysteem concluderen dat gezonde resources defect zijn en deze buiten gebruik stellen. Dit kan de capaciteit verder verminderen, waardoor een vicieuze cirkel ontstaat.
In het fictieve scenario beginnen de loadbalancers van Northstar met het controleren van nieuw opgestarte instanties voordat de netwerkconfiguratie volledig is doorgevoerd. De controles mislukken, gezonde instanties worden buiten gebruik gesteld, het verkeer verschuift naar minder overgebleven knooppunten en die knooppunten raken overbelast.
Dat patroon deed zich ook voor tijdens het AWS-evenement van 2025. AWS gaf aan dat de gezondheidscontroles van de Network Load Balancer soms mislukten terwijl de netwerkstatus voor nieuwe instanties nog werd doorgegeven, wat ertoe leidde dat capaciteit uit de dienstverlening werd gehaald. Dit is een herinnering dat failover-logica moet worden beperkt in het aantal aanvragen en moet worden getest onder gedeeltelijke uitval, en niet alleen onder schone "gezonde/ongezonde" omstandigheden.
7. Storingen in het datacenter, de stroomvoorziening, de koeling en de beschikbaarheidszones blijven mogelijk.
Niet elke storing begint in de software. Stroomvoorziening, koeling, glasvezel, netwerkhardware en andere fysieke infrastructuur kunnen uitvallen. Cloudarchitectuur is ontworpen met deze realiteit in gedachten, en daarom verdelen grote providers regio's in foutgeïsoleerde zones.
Microsoft legt uit dat Azure-beschikbaarheidszones afzonderlijke groepen datacenters zijn met onafhankelijke stroomvoorziening, koeling en netwerken. Microsoft merkt ook op dat een zone-implementatie niet automatisch een zone-uitval overleeft; klanten moeten meerdere zones of zone-redundante services gebruiken waar dit wordt ondersteund. Zie het officiële overzicht van Azure-beschikbaarheidszones van Microsoft .
In de praktijk kan een cloudprovider een zone onafhankelijk maken, maar een klantworkload kan nog steeds een database in één zone hebben, afhankelijk zijn van één regionale beheersinstantie of een failoverproces hebben dat nog nooit is getest.
Waarom een cloudstoring er wereldwijd uit kan zien, zelfs als de oorzaak regionaal is.
"Wereldwijde storing" beschrijft vaak de impact op de klant, niet de fysieke locatie van de defecte apparatuur. Een regionale service kan ondersteuning bieden voor authenticatie, DNS, metadata, build-pipelines, dashboards of API's die vanuit andere regio's worden gebruikt. Applicaties over de hele wereld kunnen daarom uitvallen omdat ze afhankelijk zijn van een service die op één locatie geconcentreerd is.
Dit onderscheid is belangrijk bij het diagnosticeren van een incident. Ingenieurs moeten twee verschillende vragen stellen: Waar is de eerste storing opgetreden? en Welke afhankelijkheden hebben ervoor gezorgd dat die storing zich kon verspreiden? De antwoorden daarop zijn vaak verschillend.
Hoe de waarschijnlijke oorzaak te achterhalen tijdens een incident in de praktijk
Voor beheerders is het meestal het snelst om symptomen te correleren in plaats van elk product afzonderlijk te onderzoeken. Als veel services tegelijkertijd uitvallen, zoek dan naar een gedeelde afhankelijkheid. Als bestaande workloads gezond blijven terwijl nieuwe implementaties uitvallen, vermoed dan een probleem met het controlepaneel, de planning, de capaciteit of de provisioning. Als IP-connectiviteit werkt, maar servicenamen niet, onderzoek dan DNS. Als het foutpercentage stijgt na een herstelmelding, zoek dan naar herhalingspieken, achterstanden, verlopen leases, feedbackloops in de health checks of onvoldoende herstelcapaciteit.
Statussystemen van providers kunnen ook helpen om een platformincident te onderscheiden van een applicatiespecifieke fout. Google Cloud publiceert bijvoorbeeld actuele en historische incidenten via het officiële Service Health-dashboard , terwijl AWS samenvattingen van belangrijke gebeurtenissen publiceert via de officiële Post-Event Summaries .
Wat klanten kunnen doen om de impact te verminderen
Geen enkele architectuur kan gegarandeerd nul downtime bieden, maar diverse ontwerpkeuzes kunnen de kans op downtime verkleinen. Gebruik meerdere beschikbaarheidszones voor productieworkloads wanneer de service dit ondersteunt. Voor workloads die geen regionale uitval kunnen tolereren, is het raadzaam om ontwerpen met meerdere regio's te evalueren en de afwegingen met betrekking tot dataconsistentie te begrijpen. Elimineer verborgen single points of failure, zoals één regionale identiteitsservice, één DNS-pad of één administratieve API waarvan elke herstelactie afhankelijk is.
Applicaties moeten ook gecontroleerd falen. Dat kan betekenen dat gecachede content wordt aangeboden, niet-kritieke schrijfbewerkingen in de wachtrij worden geplaatst, herhaalpogingen worden beperkt met exponentiële backoff en jitter, besturingsvlakbewerkingen worden gescheiden van dataverkeer en een gereduceerde "alleen-lezen"- of "kerntransactie"-modus wordt behouden tijdens gedeeltelijke uitval. Herstelprocedures moeten worden getest onder omstandigheden met een achterstand, omdat het herstarten van een afhankelijkheid in een lege testomgeving heel anders is dan het herstellen ervan terwijl miljoenen verzoeken wachten.
De belangrijkste les uit de wijdverspreide uitval van de cloud
Laten we terugkeren naar het Northstar Cloud-scenario. De configuratiewijziging van 10:05 uur is mogelijk de oorzaak, maar niet de volledige verklaring. De storing verspreidt zich over een groot gebied omdat het netwerk gedeeld wordt, de automatisering een timingfout bevat, downstream-services afhankelijk zijn van dezelfde status, health checks capaciteit wegnemen, herhaalpogingen de belasting verhogen en herstelsystemen een enorme achterstand moeten verwerken.
Dat is het centrale patroon achter veel grote cloudincidenten: de initiële storing is vaak klein in vergelijking met de keten van afhankelijkheden die deze versterkt. Inzicht in clouduitval betekent daarom dat zowel de hoofdoorzaak als de verspreiding ervan onderzocht moeten worden. De meest robuuste ontwerpen gaan ervan uit dat individuele componenten zullen falen en richten zich op het voorkomen dat deze storingen systeemwijde gebeurtenissen worden.